


Речевая аналитика объединяет несколько технологий, каждая из которых решает отдельную задачу анализа разговора. Распознавание речи преобразует аудио в текст и определяет участников диалога. Поиск по словарю выявляет употребление заданных слов и фраз. Автотегирование классифицирует разговоры по заданным темам и признакам. Языковая модель анализирует контекст, выявляет смысл разговора, оценивает действия участников и определяет, какие шаги были выполнены или упущены.
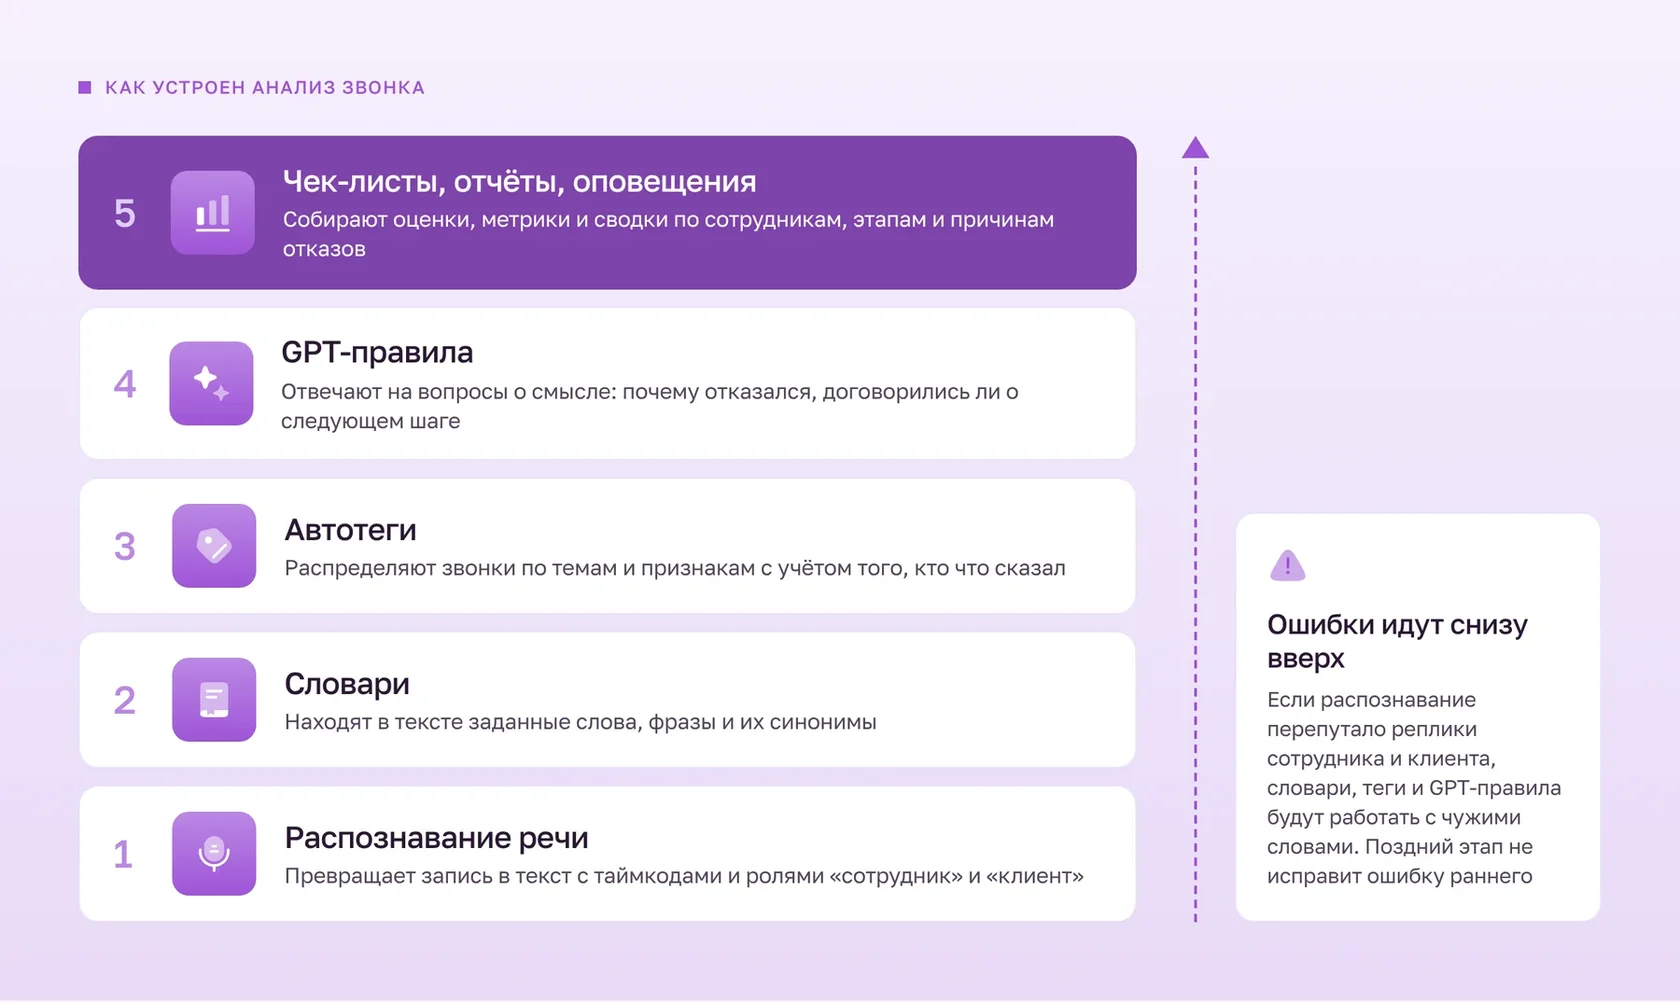
Технологии речевой аналитики работают цепочкой, поэтому ошибку раннего этапа поздний не исправит: если распознавание перепутало реплики сотрудника и клиента, самое точное GPT-правило будет оценивать чужие слова.
Из каких технологий речевой аналитики состоит анализ звонка
Архитектура речевой аналитики imot.io состоит из пяти последовательных ступеней, каждая из которых выполняет свою функцию в обработке и анализе разговоров.
- Распознавание речи (STT/ASR) преобразует аудиозапись в транскрипт с таймкодами и идентификацией участников диалога.
- Словари выявляют в транскрипте заданные слова, фразы и речевые конструкции.
- Автотегирование классифицирует разговоры на основе словарей, заданных условий и взаимосвязей с другими тегами.
- GPT-правила направляют языковую модель на анализ содержания и контекста разговора по заданным критериям и возвращают результат в структурированном формате.
- Чек-листы, отчёты и оповещения агрегируют результаты анализа, формируя оценки, метрики и сводки по сотрудникам, этапам коммуникации и причинам отказов.
Распознавание речи
Всё, что дальше делает речевая аналитика, она делает с текстом. Распознавание отдаёт транскрипт с таймкодами, по которым из любого тега или ответа модели можно перейти к нужному месту записи, и с разметкой ролей. Перед отправкой в языковую модель система расставляет в тексте пунктуацию, чтобы модель точнее видела, где закончилась одна реплика и началась другая.
Роли надёжно определяются на стереозаписи, где сотрудник и клиент пишутся в разные каналы.
Цифра точности «95%» или «99%» без методики мало что сообщает: важно, на каких записях её считали и какие ошибки учитывали. Как читать такие цифры и что такое WER, разобрано в статье о точности распознавания речи.
Транскрипт разговора сам по себе не отвечает ни на один управленческий вопрос: из расшифровки тысячи звонков руководитель не узнает, сколько клиентов отложили решение и у скольких из них есть дата следующего контакта. Чем расшифровка отличается от анализа, разбираем в статье транскрибация и речевая аналитика.
Словари речевой аналитики: прозвучала ли фраза
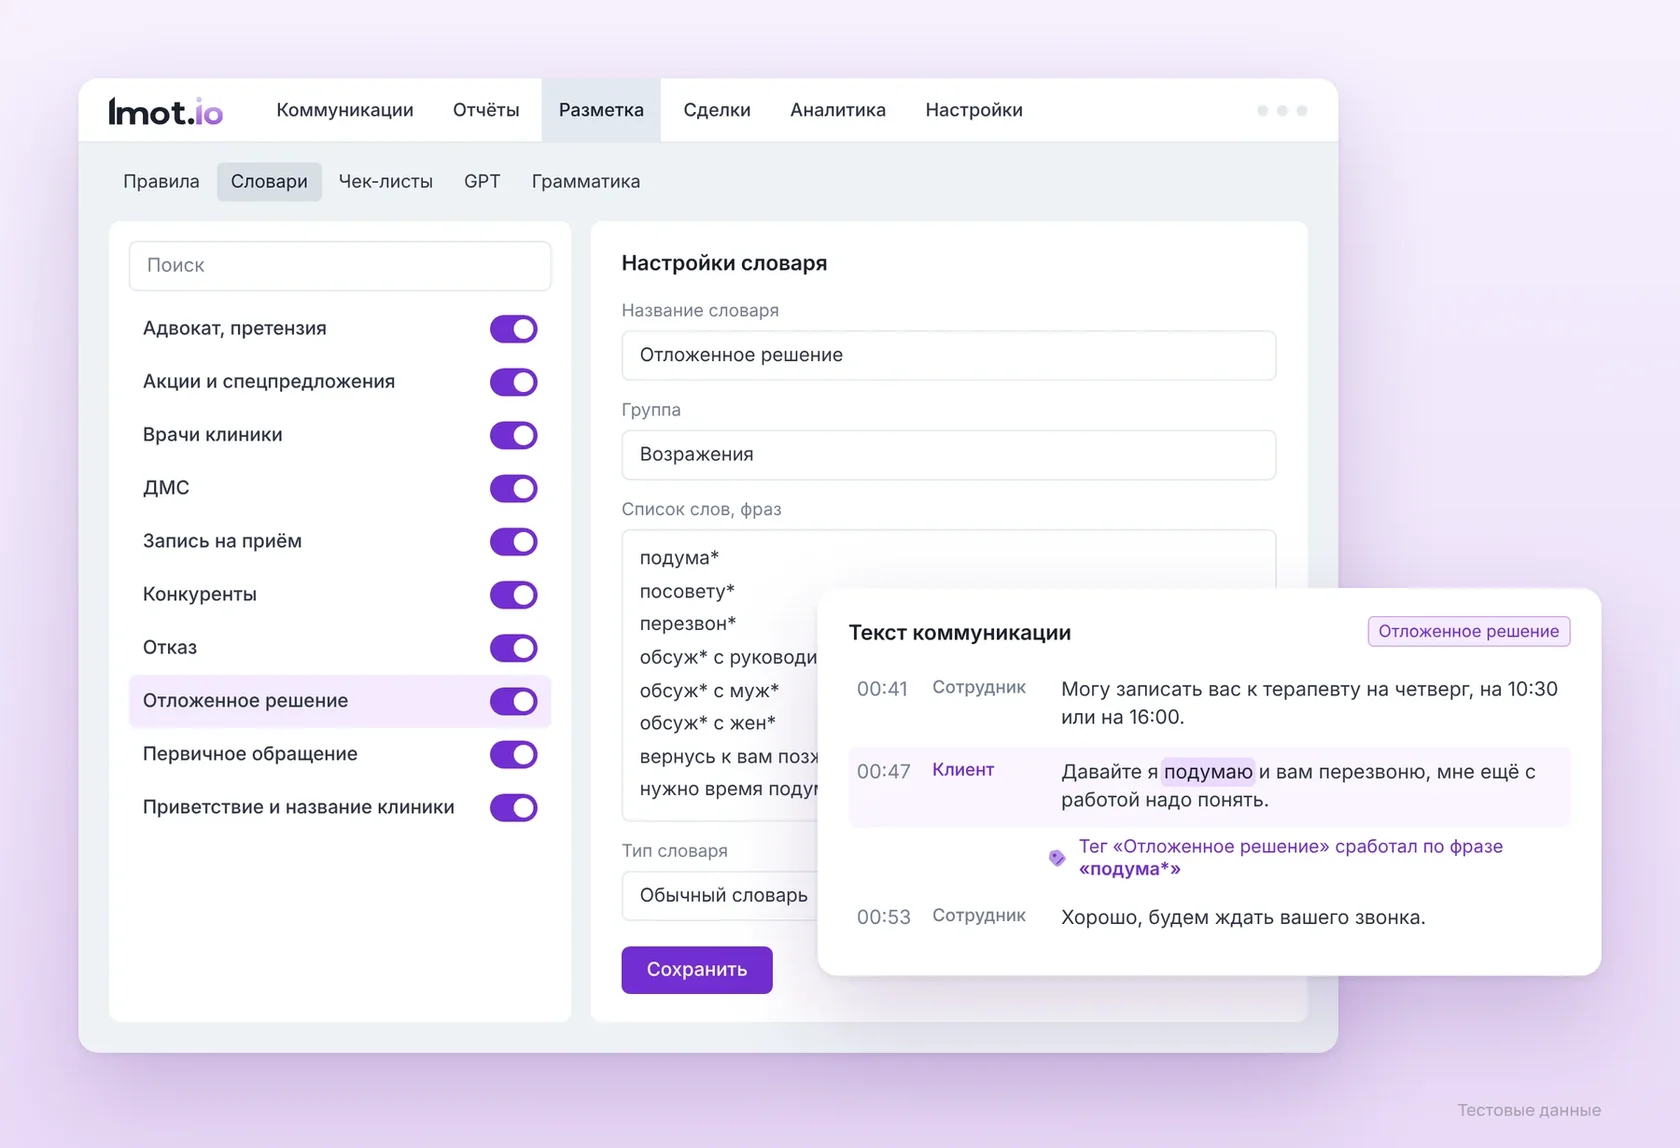
Словарь в imot.io – список фраз и их синонимов, по совпадению с которыми срабатывает тег. В карточке звонка видно, по какой именно фразе он сработал, поэтому ложное срабатывание находят сразу. Специфику отрасли закладывают словарями и правилами. В медицине это препараты, услуги, анализы и сокращения, к которым клиника добавляет фамилии своих врачей и названия своих услуг. У застройщика в словарь попадают названия жилых комплексов и ипотечных программ.
Поиск по ключевым словам в звонках
Искать слова и фразы в звонках можно и без настройки тегов. Система найдёт все разговоры, в которых они прозвучали, и покажет, кто именно их произнёс. Например, упоминания цены со стороны клиента и сотрудника дадут разные результаты: в одном случае клиент сам спросил о стоимости, в другом – сотрудник назвал её первым.
Поиск по словарю особенно полезен в трёх случаях:
- Поиск редких ситуаций с высоким финансовым или репутационным риском. Например, в клинике эстетической медицины сплошной поиск нашёл звонки со словами «ожог», «аллергия», «адвокат». Такие звонки — единицы на тысячи, и в выборочную прослушку они почти не попадаю
- Поиск конкретных упоминаний: названий услуг, врачей, акций, конкурентов, программ вроде «семейной ипотеки».
- Проверка обязательных фраз: поздоровался ли сотрудник, назвал ли компанию.
Но у поиска по словам есть ограничения. Это хорошо видно на двух примерах отказов из исследования:
«Завтра нет? Не получится… нет, не надо тогда».
«Это уже поздно. Нет, всё, спасибо большое, до свидания».
В обоих случаях клиент отказался, но ни одной заранее заданной фразы из словаря «Отказ» в разговоре нет. Система не поймёт, что клиент отказался, если нужных слов в словаре не предусмотрено. На рынке этот разрыв часто закрывают ML-классификаторами — моделями, которые обучают на размеченных звонках самой компании, и для них нужна обучающая выборка. Как это решают GPT-правила — ниже.
Есть и другая особенность: словарь находит то, что прозвучало, но не может определить, чего в разговоре не было. Например, он найдёт фразу «давайте созвонимся в четверг», но не определит, что после слов «я подумаю» сотрудник так и не предложил следующий шаг.
Рассмотрим, как работает словарь на примере возражения «Отложенное решение». В него добавляют фразы «подумаю», «посоветуюсь», «перезвоню», «обсужу с руководителем», «обсужу с мужем». По ним система отбирает подходящие звонки.
Но одного списка недостаточно. Например, фраза «я подумал и решил записаться» тоже попадёт в результаты, хотя клиент уже принял решение. Чтобы убрать такие случаи, добавляют стоп-слова. А если система пропускает выражения вроде «давайте я вернусь к вам позже», словарь дополняют новыми формулировками.
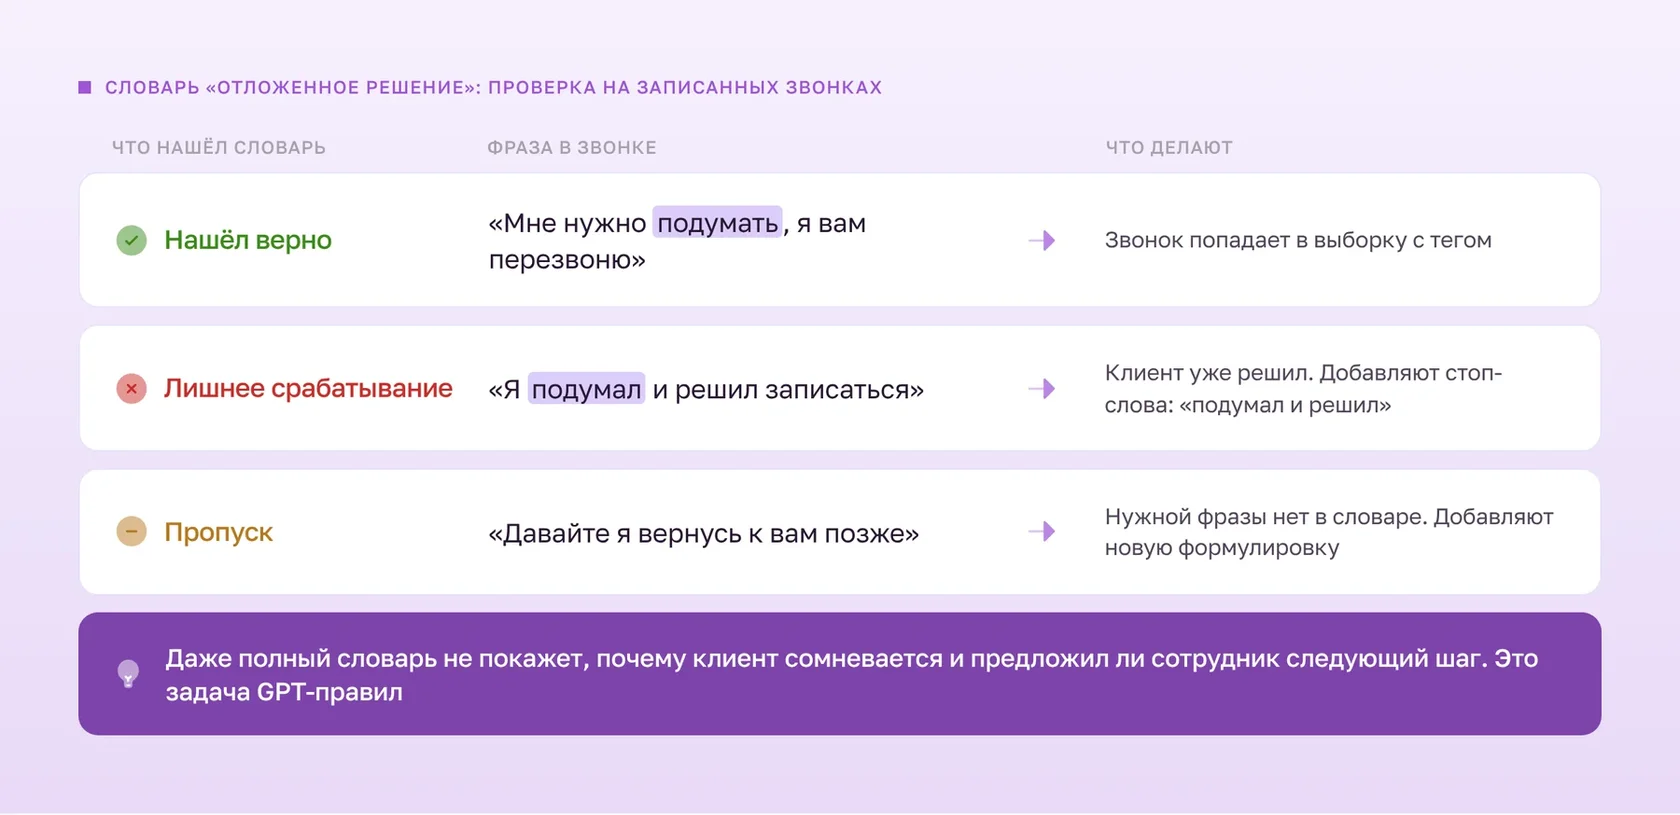
Перед запуском словарь проверяют на уже записанных звонках: смотрят, какие фразы находятся правильно, а какие дают лишние результаты или пропуски. Это можно сделать и через API. При этом даже самый полный словарь не определит причину сомнений клиента и не оценит, предложил ли сотрудник подходящий следующий шаг. Для этого нужны GPT-правила.
Автотеги в звонках
Тег – это метка, которая помогает быстро найти звонки на определённую тему или с нужным результатом. Например, обращения по ДМС, вопросы о конкретном враче или звонки, в которых клиент отложил решение.
Автоматически присваивать такие метки помогают правила. Они ищут в расшифровках нужные слова и фразы, учитывают, кто именно их произнёс, и проверяют дополнительные условия. Например, тег «Отложенное решение» появится, если клиент сказал, что ему нужно подумать. Если ту же фразу произнёс администратор, тег не поставится.
Так автоматическое тегирование звонков раскладывает тысячи разговоров по темам, а нужные для анализа можно отобрать. Из отчёта можно перейти к конкретным разговорам и послушать, что произошло.
Набор тегов зависит от задач компании. В клинике это могут быть первичное и повторное обращение, ДМС, направление к врачу и результат звонка. С помощью таких меток можно, например, выяснить, к каким специалистам пациенты записываются чаще всего и хватает ли у них свободных окон. В отделе продаж теги обычно отражают этапы сделки, интерес к продуктам и источники заявок.
Теги могут работать не только самостоятельно, но и вместе с другими правилами. Например, словарь отметил звонок тегом «Отложенное решение», а GPT-правило уточнило причину и следующий шаг. Дальше результат проверяется по чек-листу и попадает в отчёт.
В кабинете можно посмотреть, как правила связаны между собой. Это помогает заметить проблемы: например, тег предусмотрен в одном правиле, но нигде не используется; или, наоборот, другие правила ждут тег, который не появляется. Там же видно, что перестанет работать, если отключить какое-то правило.
Важно, что одинаковые по названию теги в разных компаниях не обязательно означают одно и то же. В исследовании «О чём звонят в клинику» авторы не стали использовать готовую разметку клиник: она различалась настолько, что сравнивать результаты было некорректно. Это всё равно что складывать градусы Цельсия и Фаренгейта. Поэтому теги настраивают под процессы конкретной компании. А если нужно сравнить несколько компаний, звонки размечают заново по единой схеме. Подробнее о том, чем тег отличается от пункта оценки, – в статье «Чем тег отличается от чек-листа».
LLM в речевой аналитике
Нейросеть помогает разобраться в том, чего нельзя определить простым поиском слов. Например, почему клиент отказался, договорились ли стороны о следующем контакте и насколько уместным было предложение сотрудника. Результат зависит от трёх вещей: какой текст получает модель, какой вопрос ей задают и в каком формате она должна ответить. Именно на этом строится анализ звонков с помощью языковых моделей.
Как речевая аналитика понимает смысл разговора
В imot.io за смысл разговора отвечают GPT-правила. Каждое такое правило задаёт модели вопрос по расшифровке звонка и определяет, в каком виде она должна ответить: текстом, числом, «да/нет» или выбрать вариант из списка.
Если ответ нужно выбрать из списка, модель не сможет предложить собственную формулировку, только один из заданных вариантов. В список обязательно добавляют пункт «Другое / нет данных». Иначе модель может выбрать не совсем подходящий ответ, если не найдёт точного совпадения. В отчёте такая ошибка останется незаметной.
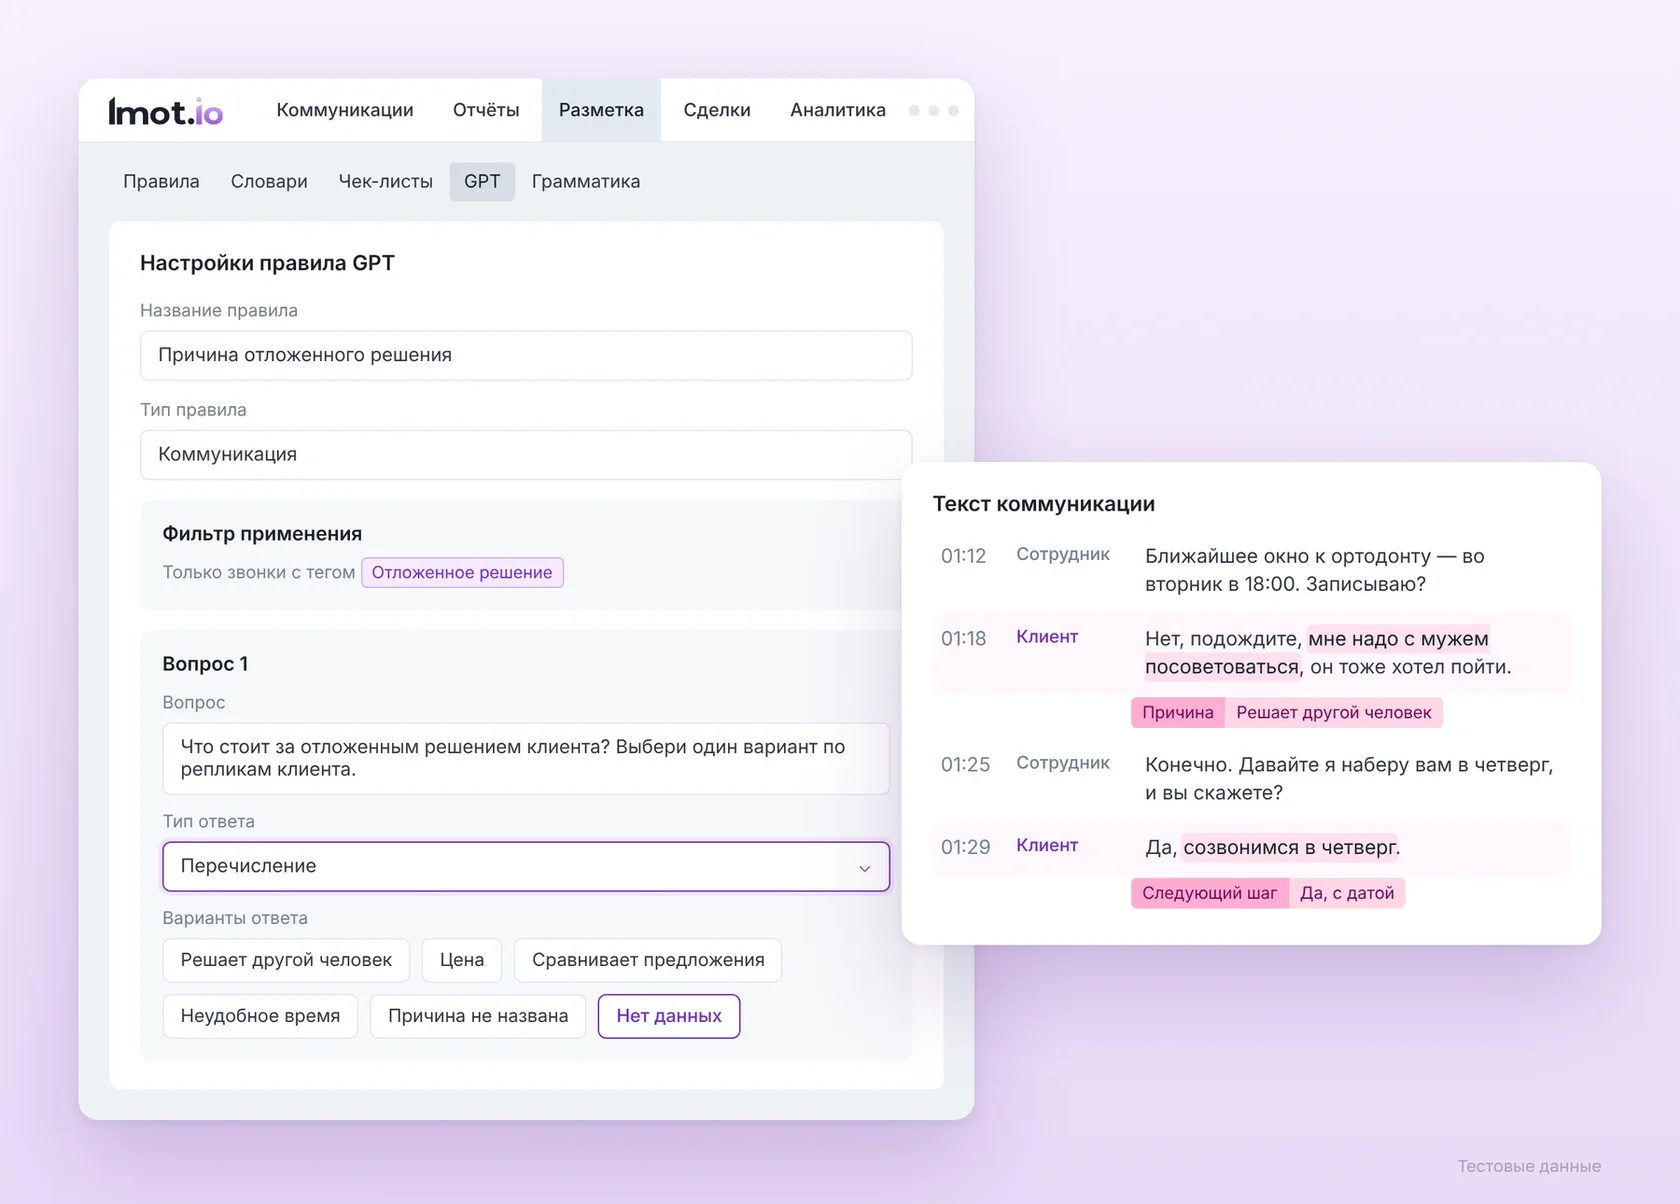
Чтобы разобраться в звонках с тегом «Отложенное решение», достаточно двух GPT-правил:
Правило 1. «Что стоит за отложенным решением клиента?» Варианты ответа: решает другой человек; цена; сравнивает предложения; неудобное время; причина не названа; нет данных.
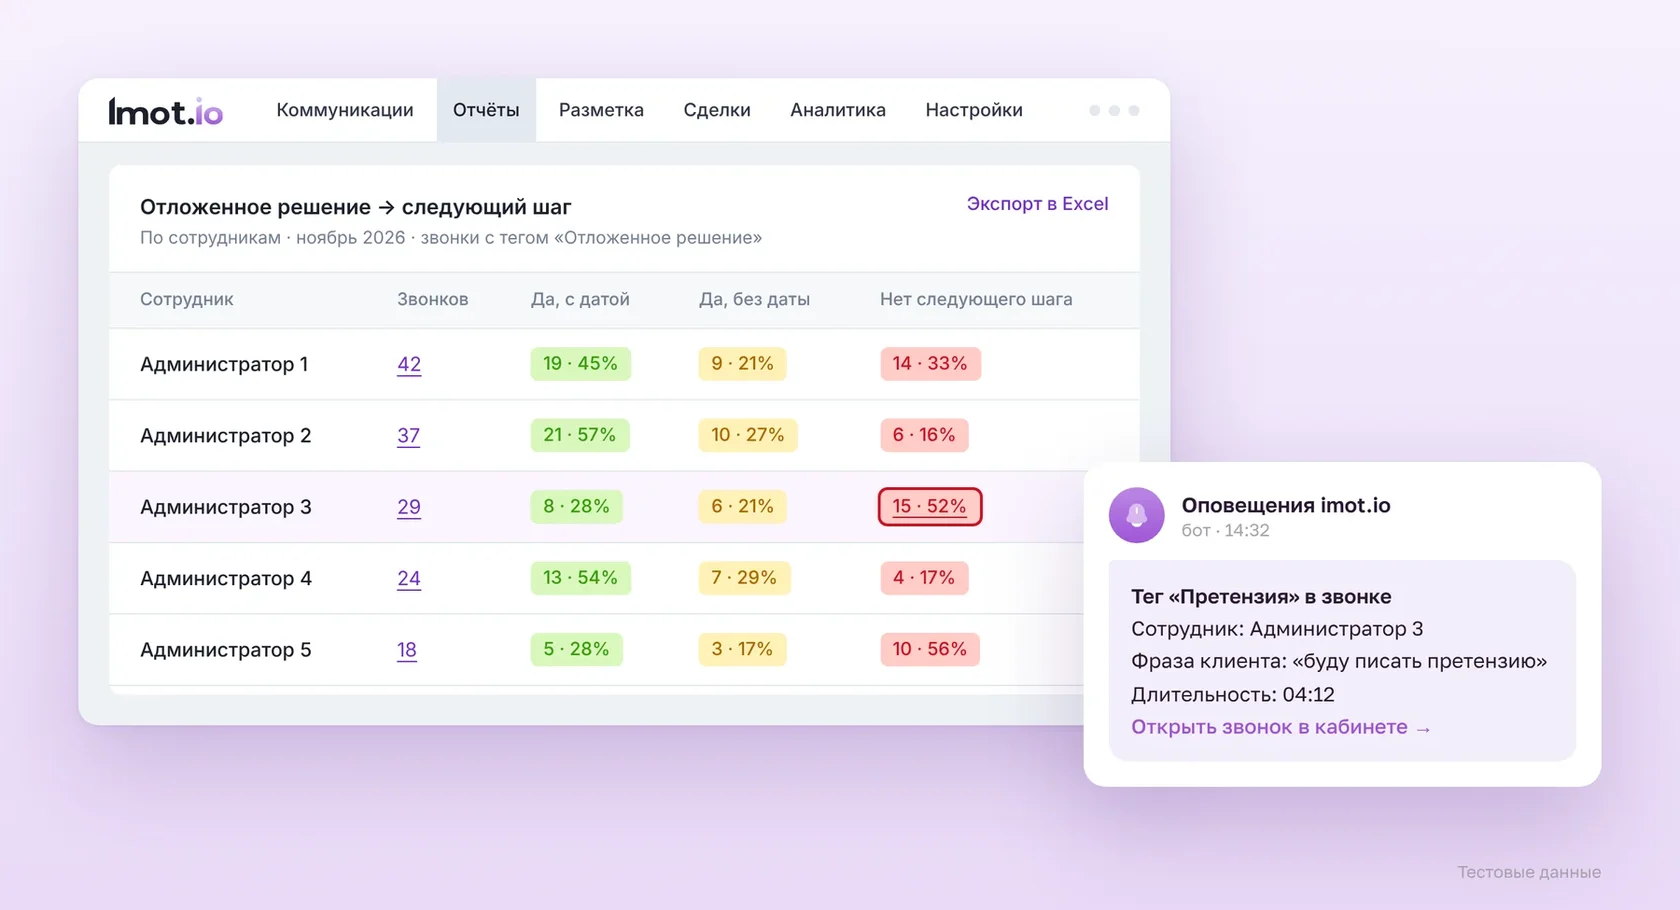
Правило 2. «Договорились ли о следующем шаге?» Варианты ответа: да, с датой; да, без даты; нет.
Если клиент говорит: «Созвонимся в четверг», система может определить дату следующего контакта и передать её в Битрикс24, чтобы создать задачу. При этом GPT-правило не просто присваивает тег, а отмечает конкретную фразу в расшифровке. Рядом с результатом видно, на какие слова опиралась модель. Поэтому проверить её решение можно за несколько секунд, не переслушивая весь звонок.
Второе правило помогает увидеть то, что обычный чек-лист не замечает. Например, в одной клинике эстетической медицины возражение «подумаю» отрабатывали в 17–23,5% звонков, где клиент его произнёс. Проверили 15 разговоров, в которых система отметила возражение как отработанное. Только в трёх из них администратор договорился с клиентом о дате бронирования или времени следующего звонка. Формально возражение закрыто, но конкретной договорённости нет.
Чтобы проверить, чем закончилась такая ситуация, можно настроить правило на уровне сделки. Оно анализирует все коммуникации с клиентом: звонки, чаты и встречи, и определяет, состоялся ли обещанный контакт и к чему он привёл.
Такой подход полезен и в продажах. Например, застройщику важно знать, предложил ли менеджер семейную ипотеку покупателю, который рассказывал о детях и желаемом размере платежа. Поиск по словарю найдёт упоминания ипотеки, а GPT-правило определит, был ли подходящий момент для предложения и воспользовался ли им менеджер.
Кроме того, система может составлять краткое содержание каждого разговора, извлекать из него конкретные данные, например, суммы и количество. Новые GPT-правила можно применять не только к будущим звонкам, но и к тем, которые уже сохранены в кабинете.
При этом результаты GPT-правил не стоит воспринимать как безусловно точные. Языковая модель может ошибаться и даже добавлять в резюме информацию, которой не было в разговоре. Почему это происходит и как снизить риск таких ошибок с помощью правильной формулировки правил, разбираем в статье почему модель дописывает лишнее.
Чек-листы и отчёты: как всё работает вместе
Чек-лист помогает оценить звонок по заданным критериям. Для этого используются теги и вопросы к GPT. При этом система учитывает, какие пункты подходят к конкретному разговору, а какие нет. Например, если пациент отменяет запись, проверять, предложил ли администратор время для визита, не нужно. Поэтому из пяти пунктов чек-листа в таком звонке оцениваются только два, а итоговый балл рассчитывается по ним. Как собрать пункты, разобрано в статье как составить чек-лист оценки звонков.
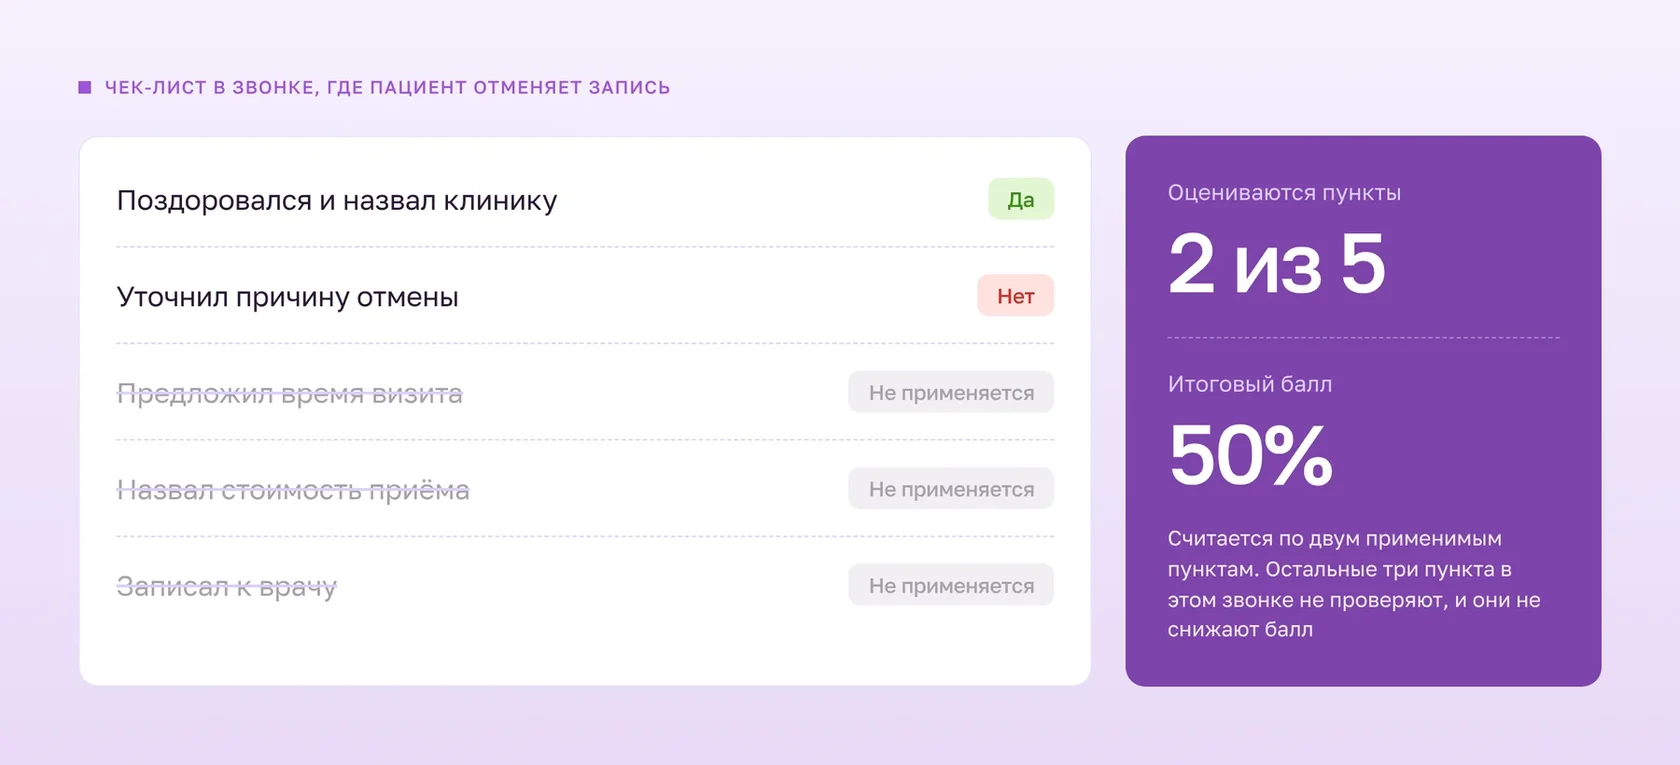
Отчёты собирают результаты оценки и показывают их в разрезе сотрудников, отделов и этапов работы с клиентами. Из любой строки отчёта можно перейти к конкретным звонкам и проверить, за счёт чего получился результат.
В системе можно настроить уведомления: например, получать сообщения в Telegram, MAX, по электронной почте или в Битрикс24, когда клиент упоминает претензию или звонок получает определённый балл.
Те же правила можно применять не только к звонкам, но и к переписке с клиентами.
Как проверить разметку, прежде чем ей доверять
Настройка системы занимает от двух недель. В это время идёт калибровка: сотрудники и система оценивают одни и те же звонки, а расхождения помогают уточнить правила. Если контролёр сомневается, что модель понимает контекст, можно вместе проверить несколько разговоров и сравнить результаты.
В кабинете есть инструменты для проверки и корректировки. Можно посмотреть, почему GPT поставил тег, проверить и улучшить формулировку инструкции, вручную исправить тег или оспорить оценку по чек-листу. Если апелляцию принимают, балл и отчёты пересчитываются. Поскольку от оценки часто зависит премия, её расчёт лучше начинать после калибровки.
Проверять речевую аналитику лучше поэтапно: сначала качество записей, затем работу словарей на реальных транскриптах, после — точность GPT-правил и совпадение результатов с оценками сотрудников. Если компания анализирует меньше 5 000 минут разговоров в месяц, разумно начать с небольшой ручной выборки и чек-листа.
Частые вопросы
Чем словарь отличается от GPT-правила?
Словарь ищет в транскрипте заданные фразы и их синонимы. GPT-правило задаёт языковой модели вопрос о разговоре и получает ответ в заданном формате: текст, число, «да/нет» или вариант из списка. Словарь подходит для однозначных слов и обязательных фраз, GPT-правило нужно, когда ответ зависит от контекста или от того, чего в разговоре не прозвучало.
Анализирует ли речевая аналитика интонацию и эмоции?
imot.io работает с текстом расшифровки: паузы, темп и тон голоса в анализ не входят. Причины отказов, пропущенные шаги скрипта, договорённости и возражения видны в тексте.
Можно ли анализировать звонки через ChatGPT?
На нескольких звонках можно. На потоке нужно решать, кто разделяет роли, где хранятся записи с персональными данными, как сохранить одинаковые формулировки вопросов и кто проверяет ответы.
Нужен ли программист, чтобы настроить словари и правила?
Нет. Словари, автотеги, GPT-правила и чек-листы настраиваются в интерфейсе кабинета, при запуске их помогает настроить команда внедрения. Программист понадобится, если компания хочет забирать данные через API.
Что делать, если телефония пишет звонки в моно?
Анализ на моно работает, но роли сотрудника и клиента определяются хуже, и метки вроде «представился» или «назвал компанию» становятся ненадёжными. Если телефония позволяет, стоит перейти на стереозапись.
Почему модель иногда пишет в резюме то, чего не было в разговоре?
Языковая модель достраивает ответ, когда вопрос сформулирован размыто или в разговоре не хватает данных. Риск снижают перечисление вместо свободного текста, вариант «нет данных» и проверка по фрагменту. Подробнее в статье почему модель дописывает лишнее.


